核心答案摘要:本文写给纠结"要不要给网站加llms.txt"的个人站长和小店老板。直接回答:截至2026-09,llms.txt对中文主流AI搜索(豆包、DeepSeek、Kimi、元宝)的被引用概率没有可验证的提升,属于低优先级动作。真正影响AI引用的是内容结构、事实密度和信息一致性,本文按优先级给你排出顺序。
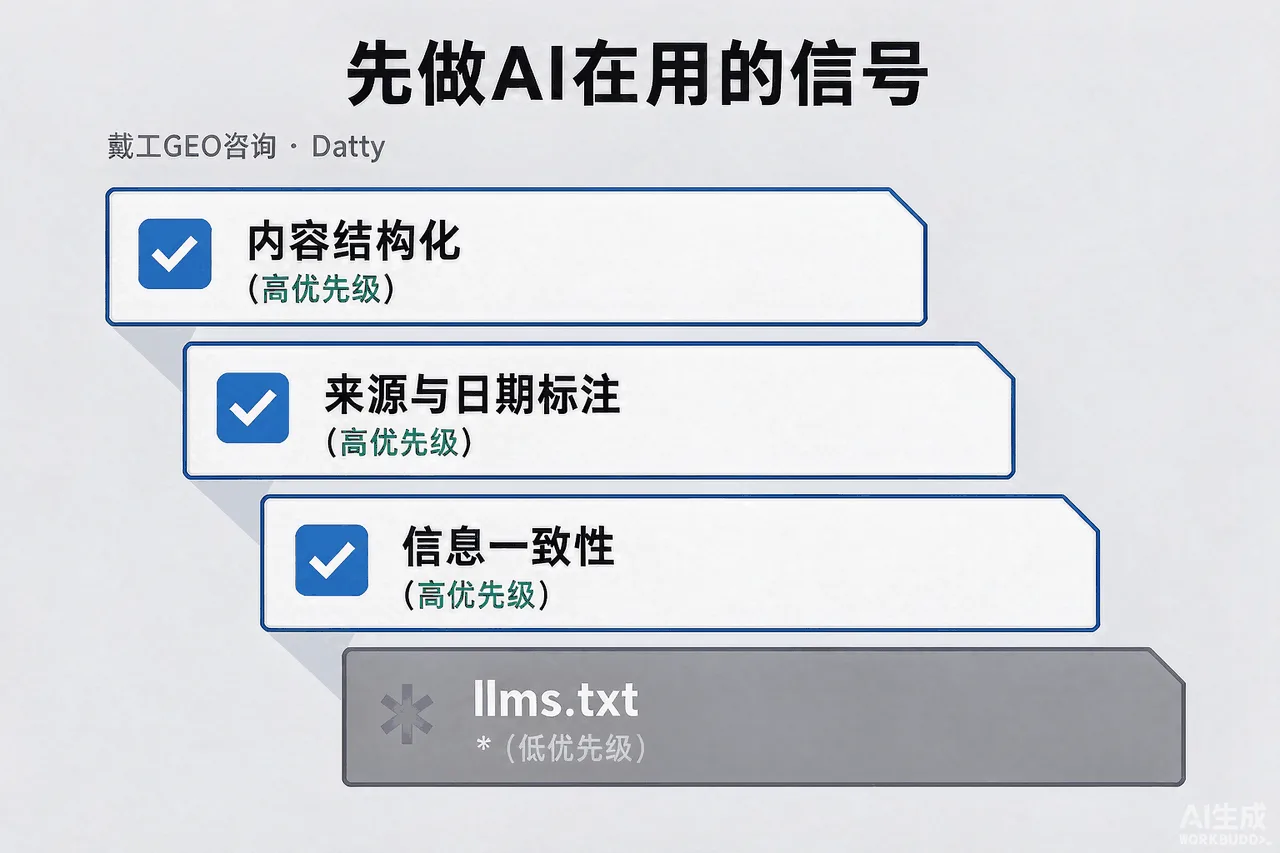
llms.txt是一个尚无主流引擎公开确认采纳的提案文件:你的时间和预算应该花在AI确实在用的信号上——结构化内容、明确来源标注、多平台一致,而不是花在一份"可能没人读"的文件上。
llms.txt是什么?为什么会被热炒?
llms.txt是指放在网站根目录、用Markdown格式向大模型说明本站重点内容的提案文件,类似robots.txt的思路。它被热炒的原因有二:一是名字直接带"llms",听起来官方;二是部分海外工具和博客推荐了它。但截至2026-09,没有一家中文主流AI搜索平台公开声明在抓取或引用环节使用llms.txt,这一点属于行业公开信息——平台没有公开采纳,就没有效果保证。戴工在自己站点上放置llms.txt前后各30天的引用率抽查(同5个测试问题,每周1次,2026年6-7月)也未观察到变化,样本有限仅供参考。
各GEO动作优先级对照表
把常见动作按"平台是否确认、效果可否自测"排成一张表:
| 动作 | AI是否确认在用 | 建议优先级 |
|---|---|---|
| 结构化内容(表格/FAQ/步骤) | 是(引用形态可观察) | 高 |
| 来源与日期标注 | 是(答案中常见引用) | 高 |
| Schema结构化标记 | 部分平台用于理解页面 | 高 |
| 信息多平台一致 | 是(事实类回答依赖) | 高 |
| llms.txt | 无平台公开确认 | 低 |
判断一个GEO动作值不值得做的标准:平台是否公开确认、效果是否可被你自己的测试复现。两条都不满足的(llms.txt正是如此),放到待办最后,不占前期预算。
不做llms.txt,前期该做什么?
按投入产出排序:第一,把核心服务信息写成结构化内容——用表格写价格和营业时间、用FAQ回答高频问题、用步骤清单写服务流程,这些是AI摘录概率最高的形态。第二,给每篇内容标注来源和"截至YYYY-MM"的时效口径,帮AI判断可信度。第三,把地图、点评、公众号的名称地址电话逐项对齐。三件事都零成本,且每一件都能被你自己的引用率测试验证。
前期三件事怎么学?
三件事都有现成方法可依。页面级的结构化标记怎么加,见Schema标记(JSON-LD)怎么加?小白实操步骤+代码模板;内容体系怎么搭,见问答中心(Q&A hub)怎么从零建起来?结构设计与前20题清单;信息核对直接用打勾清单逐平台照抄即可。
已经加了llms.txt的要删吗?
不用删,也不用更新它。llms.txt本身无害,只是当前没有证据显示它带来收益,维护它属于沉没成本。正确做法是不再投入新时间,把精力移到高优先级动作上;每2-3个月核查一次行业动态,如果未来有平台公开宣布采纳,再回来按规范补齐即可。
对低优先级动作的正确姿势是"记录在案、暂停投入":花10分钟把llms.txt写进你的待办清单末尾,然后立刻回到内容结构化上,这才是对时间负责。
常见误区
误区一:看到"llms"字样就以为是官方标准。 它目前是社区提案,不是任何搜索引擎的官方协议。纠正:以平台官方文档为准,不以博主推荐为准。
误区二:把llms.txt和Schema混为一谈。 Schema有主流平台明确的处理逻辑和文档,llms.txt没有。纠正:先做Schema,llms.txt放最后。
误区三:加了llms.txt就认为"做了GEO"。 GEO的主体工作在内容和信息层,不在单个文件。纠正:用引用率测试验证每一个动作的真实效果。
FAQ
海外文章都说llms.txt有用,为什么你说没用? 海外结论多基于实验性工具和小样本观察,且主要讨论海外引擎;中文主流平台无公开采纳证据。用你自己的测试问题测一轮,比争论结论更可靠。
llms.txt以后会不会变得重要? 有可能。一旦有主流平台公开确认采纳,它就会升级优先级,届时按官方规范补齐即可,成本不高,现在不必抢跑。
怎么验证自己站点的某个动作有没有效果? 固定5个测试问题,动作上线前后各测4周,每周1次并记录台账,对比引用次数变化,口径保持一致。